一台吃灰的旧 Kindle,被我改造成了 AI 阅读终端
家里有一台老 Kindle,2018 年的 Paperwhite。
屏幕没坏,电池还能用,但它已经很久没被认真打开过了。不是因为电子墨水不适合阅读,而是它原来的使用方式越来越跟不上现在的信息流:
想看的内容散落在网页、Markdown、RSS 和云盘里;专业论文需要翻译和解释;手机上的长文章又总被消息打断。
于是今天,我决定重新改造它。
最终,这台老 Kindle 装上了 KOReader,接通了 VPS、云存储、AI 助手、微信读书和新闻订阅。它不再只是一个存放电子书的设备,而变成了一台安静、专注、低功耗的个人阅读终端。
过程里出的岔子不止一处,但真正值得写下来的教训有两个。其中一个让我白建了一整套服务——而且它很容易被归错原因,这是这篇里我最想说清楚的部分。
一、先换掉阅读系统
改造的基础,是为 Kindle 安装第三方阅读器 KOReader。
KOReader 是面向电子墨水设备的开源阅读器。相比原生系统,它支持更多格式,也提供了更自由的排版、手势、词典、插件和网络功能。
完成必要的设备解锁后,我通过 Kindle Package Manager 装上了它。
这一步有个顺序问题值得单独提醒:动手之前先断网。
Kindle 联网时会自动检查并安装固件更新。对我这台机器来说,能不能解锁取决于它当前的固件版本——如果在准备过程中被更新上去,这条路就走不通了。所以正确的顺序是:先断网,确认版本,再决定怎么做。
我在开始前差点忽略了这一步。
另外,解锁本身是有代价的:可能失去保修,操作不当有变砖风险,出问题时的处置也得自己承担。动手前先把设备里的个人文档和标注导出备份,这一步比任何教程都重要。
第一次启动 KOReader 时,界面谈不上华丽,甚至有点“工具感”。但打开文档后就能感受到它的价值:
- EPUB、PDF、Markdown 等格式直接可读
- 字体、行距、页边距自由调整
- PDF 可以裁边、横屏、分栏和文本重排
- 支持离线词典、RSS、WebDAV 和第三方插件
- 阅读记录和标注可以导出
我先建了几个目录,放进一个普通的 Markdown 文件试水:
documents/inbox
documents/news
documents/notes
KOReader 顺利打开并正确显示了中文。这意味着 Kindle 不再局限于传统电子书——以后由电脑、脚本或 AI 生成的内容,也能成为它的阅读材料。
二、一次白干:那套用不上的自建服务
只靠 USB 拷文件当然不够。我的目标是:内容在 VPS 上生成,Kindle 一联网就能收到。
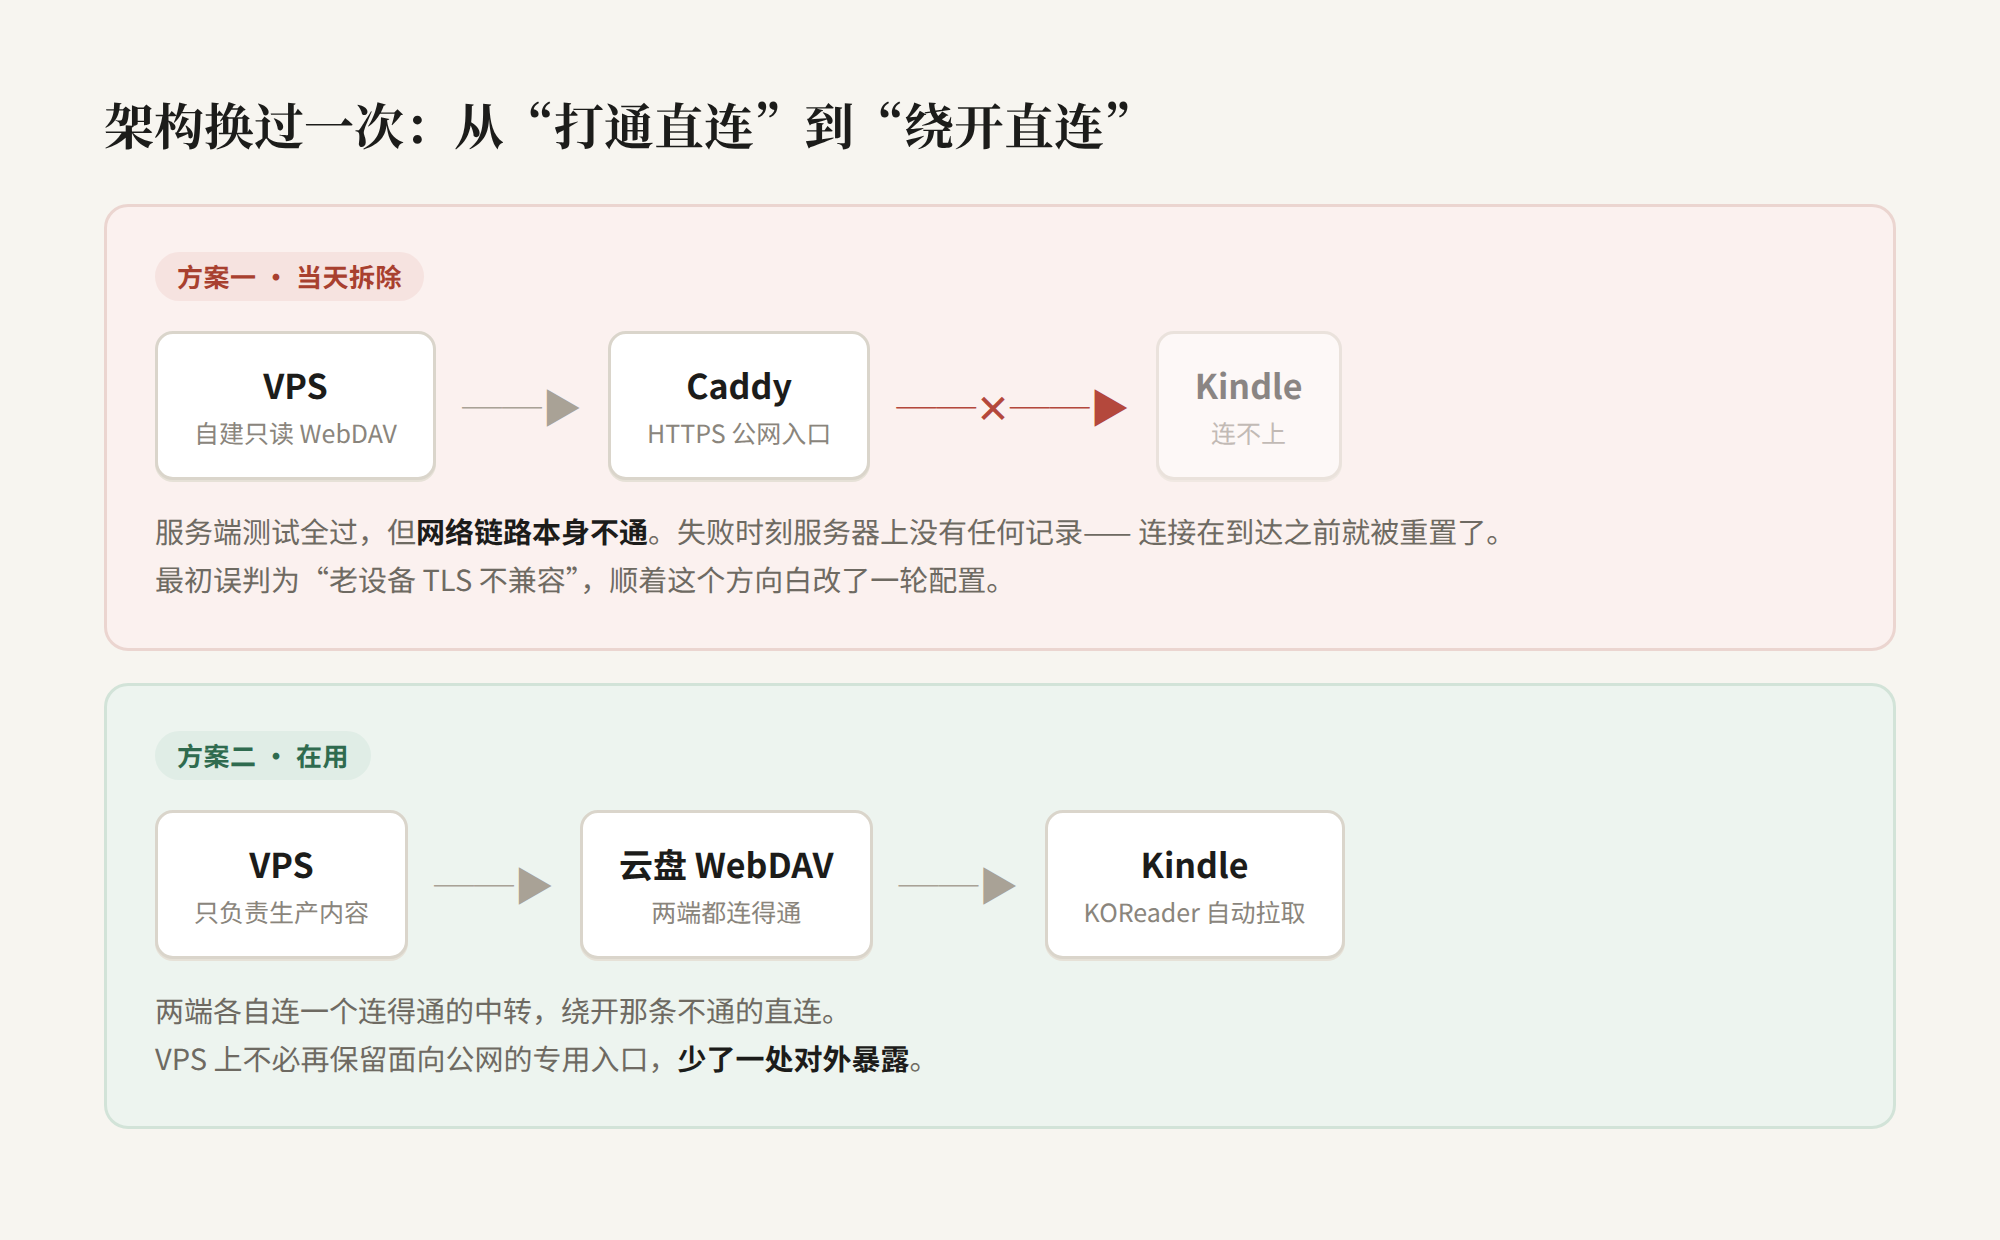
最初的方案是在 VPS 上搭一个只读的 WebDAV 服务,由 Caddy 提供 HTTPS 入口。
这台 VPS 上还跑着我自己的几个站点,所以我最在意的不是“能不能通”,而是“万一这个新入口出事,会不会连累别的服务”。做法是尽量把它隔离出去:专用系统用户、只读、限死 CPU 和内存、只监听本机地址,Caddy 只做反向代理,连密码校验都放在那个被限死资源的独立进程里。
这样能把后端进程的影响范围圈住,但要说清楚:它并不能消除反向代理和共享主机层面的风险——连接数、内核资源这些仍然是共用的。
服务端测试全部通过:匿名访问被拒、错误密码被拒、正常读取正常、内容哈希一致、各种写入方法被拦、路径穿越无效。
然后连 Kindle,失败了。
KOReader 反复报错:
无法获取文件夹内容列表
日志里是 Connection reset by peer——连接在收到任何响应之前就被重置了。
看到这个报错,最自然的猜测是设备太老:2018 年的机器,TLS 实现陈旧,可能不支持现代加密套件,或者证书链里有它不认识的根证书。
我一开始也这么想,并顺着这个方向改了一轮配置。没用。
于是转去查服务端,结果是这样的:
- 失败的那两个时刻,服务器上没有任何相关记录。 连一次失败的握手都没留下。
- 我模拟了一个不发送 SNI 的老式客户端去连,服务器正常完成握手。
- 只用 TLS 1.2 和保守加密套件去连,同样正常。
- 证书链校验通过。
这些只能说明一件事:在我测到的那几种老式握手条件下,服务端都是通的——最常见的几种服务端病因可以排除。它既不能覆盖所有老客户端,也不足以证明 Kindle 本身没问题。
真正把方向掰过来的,是换个角度试的结果——我这边的网络到那台海外 VPS 本来就连不上。
准确地说:网络链路本身已经足以解释这次失败,我没有再继续验证 Kindle 是否还叠加了别的兼容问题。因为已经不必了——这条路本来就走不通。
我花了不少时间建了一套隔离良好、测试完备的服务,测试全过,然后发现它从我的网络根本用不了。当天就拆掉了。
这件事的教训不在技术细节,而在顺序:我把“设备兼容性”当成了最大的风险,却漏掉了更基本的一件事——这台设备到底能不能连上这台服务器。
如果你也打算做类似的事,建议把顺序倒过来:先用最简单的方式确认这条链路能通,再去考虑架构、权限和安全。 需要留意的是,“通不通”要在尽可能接近实际使用的条件下验证——用电脑在同一个 Wi-Fi 下测,只能说明这个网络的出口大致可用,Kindle 自身的网络栈仍可能有别的问题。但即便如此,先花五分钟做个粗测,也远好过等整套服务建完才发现方向错了。
三、换条路:让云盘做中转
拆掉公网入口后,链路变成了:
VPS → 云盘 WebDAV → Kindle
VPS 仍然负责内容处理,但不再向 Kindle 暴露任何服务。它把整理好的文件同步到云盘,KOReader 再通过云盘的 WebDAV 接口读取。
好处很直接:两端各自连一个都连得通的中转,绕开了那条不通的直连;VPS 上不必再保留面向公网的专用入口,少了一处对外暴露;手机和电脑也能看同一批内容。
我也评估过“邮件推送到 Kindle”这条路——把文件发到个人文档邮箱,由亚马逊负责投递。好处是完全不用自己搭服务,代价是内容要经过第三方;另外我这台 VPS 的对外发信端口是被封的,直接走 SMTP 行不通。
云盘这条路测下来很顺:VPS 推送的中文 Markdown 能到云端,Kindle 也能正常浏览、下载和打开。
不过 KOReader 默认的云存储更接近“远程文件浏览器”,每次仍要手动进去下载。所以我又加了一层自动化。
四、让它自己去取
我为 KOReader 加了一个启动补丁:开机检查网络,然后从指定的 WebDAV 目录单向拉取新文件到 documents/inbox。
只下载,不上传,也不删云端文件。双向同步最麻烦的地方从来不是“同步”,而是冲突和误删——单向拉取直接绕开这一类问题。
第一次运行时补丁没报错,文件却没出现。排查后发现,KOReader 的 WebDAV 接口返回的字段是 type = "file",而我的代码检查的是另一个字段。判断条件写错了,于是每个文件都被当成“不需要下载”。
改对之后,云端文件自动出现在 inbox 里,中文文件名和内容都正常。
链路至此打通:
电脑 / 脚本 / AI
      ↓
     VPS
      ↓
     云盘
      ↓
 Kindle 自动拉取
      ↓
documents/inbox
以后我只需要在 VPS 上跑一条推送命令。
五、把 AI 放进阅读过程
接下来是 KOReader 的 AI Assistant 插件。它能读取书中选中的文字,调用大模型完成翻译、总结、解释术语、分析段落、提取论点。
配置时遇到了 400 Bad Request。原因不是网络,是模型名称——插件有一套自动选择模型的逻辑,它选出来的那个名字在我的账号上并不存在。
排查时顺带发现了另一件事:可用的模型名会调整,而旧别名指向的底层模型也可能已经换了。 我印象里那些用了很久的旧名称,在我排查当天仍然能调通,但返回结果显示它实际跑的已经是新一代模型。也就是说配置里写的东西和实际在跑的,早就不是一回事。这个不报错,所以我一直没察觉。
结论很简单:别凭印象填模型名,先查一次账号当前实际可用的列表。
配置正确后,AI 助手就能用了。读英文论文时划选一段:
用中文解释这段话,并说明它在全文中的作用。
遇到复杂论证还能追问:
作者的假设是什么?有哪些可能的反例?
Kindle 因此从“显示文本的设备”,变成了能帮你理解文本的工具。
有两点要说清楚。
一是隐私。 你划选的原文和提出的问题会被发送给模型服务商。读公开出版物无所谓,但如果读的是内部材料、未公开的文档或者自己的私人笔记,这一点必须先想明白。API 密钥也要妥善保管,别写进会同步到云端的文件里。
二是定位。 电子墨水屏刷新慢、输入不便,这两个限制决定了 AI 在这里最合适的角色是阅读助手,不是聊天机器人:划选、提问、读完答案,继续看书。模型选择也该服从这个定位——我用的是响应更快的那一档,而不是能力最强的那一档。在一块刷新要等一下的屏幕上,多等几秒换一点回答质量,通常不划算。
六、微信读书:两条路,风险不一样
这一步需要区分两种完全不同的接入方式。
一种是官方接口。 微信读书今年发布了官方开放能力(具体发布日期以官方页面为准),在 App 里生成专属密钥后,可以读取自己的书架、划线、想法和阅读统计。走官方通道,合规性和账号风险相对可控——但密钥本身仍然要保管好,不用了就去后台撤销。
另一种是第三方 KOReader 插件。 它能让你直接在 Kindle 上读微信读书的书,体验很好,但它是非官方客户端,插件作者自己在说明里写明了账号风险自负。
我的做法是把两件事分开:读书用插件,取数据用官方接口。
官方接口这条路,让我做成了一件想了很久的事:把这些年划的线全部同步进自己的知识库。结果是 25 本有笔记的书,118 条划线,按书归档成独立文档,每本带上作者、阅读进度和最后更新时间。
过程里有个发现值得单独说:划线数据有两个来源,只取一个会静默丢数据。
有一部分划线不在“划线列表”接口里,而藏在“想法列表”接口中——那些没有写评论的记录,本质上也是划线,被划的原文放在另一个字段。
两个来源还可能指向同一段,所以要合并去重。这里有个细节:去重键不能只用正文。同一段话在书里出现两次是完全可能的,只比对文字会把合法的第二条误删掉。可靠的做法是优先用章节和位置范围这类定位字段,实在缺定位信息时才拿正文兜底。
如果只读前一个接口,程序不会报错,数据只会安静地少一部分。我是在逐份核对“文档头部声明的条数”和“正文实际条目数”时才发现的。
顺带还有个意料之外的收获:118 条划线,而我自己写下的评论是 0 条。
不是接口没返回,是我确实一条都没写过。这个数字比任何自我评估都直接——它说明我的阅读一直停在“标记”,没有走到“表达”。
七、收尾:新闻订阅与界面
KOReader 自带的 News Downloader 可以读 RSS,并把新闻条目生成适合阅读的 EPUB。我配了几个 AI 与财经来源,统一进 documents/news。
配置刻意保持克制:每个来源只下载少量新文章、只保留最近几天、默认不下载图片。电子墨水设备的优势从来不是“信息越多越好”,而是让人从信息洪流里退后一步,认真读完少数真正重要的内容。
最后装了 Zen UI,重新整理了文件浏览器、底部导航和快捷设置,最近阅读、收件箱、新闻、云存储、亮度和 Wi-Fi 都能一步到达。相比继续堆插件,一个清晰的首页对日常体验的提升反而更明显。
考虑到这是一台 2018 年的单核设备、6 英寸灰度屏,我刻意没装动态锁屏和常亮看板——前者明显更费电,后者在 6 英寸屏上排不下有用的信息。新闻限量,图片能省则省,AI 用完关 Wi-Fi。
旧设备改造的重点不是把功能塞满,而是在它的能力范围内建立一套稳定顺手的工作流。
八、藏在整个过程背后的那个工具
上面这些步骤——装阅读器、写启动补丁、配插件、查报错——单看每一项都不难, 但它们有个共同点:步骤多,每一步都能出错,而且错了不一定当场报错。 版本不匹配、目录名差一个字、压缩包多套了一层文件夹,症状往往都是"装了但没反应"。
这次的做法是把 Kindle 当成一台外接存储设备。用数据线接上电脑后,它在系统里就是一棵 可读可写的目录树——对运行在本地的 AI 工具来说,这意味着它可以直接检查目录结构、 读 KOReader 的配置、建文件夹、把插件放到该去的位置。
拿刚才那个 Zen UI 举例。我给的指令是一句"安装这个",它做的事是:
先确认 Kindle 已被电脑识别;扫一遍插件目录,看有没有 Simple UI、Project Title
这类可能冲突的组件;确认无冲突后,从项目的正式发布页里挑出与当前 KOReader 版本
匹配的稳定版;下载、算哈希、检查压缩包结构;复制到
koreader/plugins/zen_ui.koplugin;装完再回头验插件入口文件、版本号和文件数量。
(顺带说明:这里算哈希只是用于留档和传输前后比对。它并不等于安全校验—— 真要验证来源可信,得拿计算结果去和发布方公布的校验值比对,这一步我没做。)
前面那个自动同步不下载文件的 bug,也是同一种模式排查出来的:把配置和接口实际返回的 结构摆在一起比对,字段名对不上就一眼看出来了。
配微信读书、AI 助手、新闻订阅时,承担的也都是这类机械但容易出错的活:确认插件来源、 查兼容版本、检查安装目录、写配置文件、分析 API 报错、调接口地址和模型名、验文件结构。
但要说清楚它的边界。 这一天里最大的一次弯路——把连接失败归因于"老设备 TLS 不兼容", 顺着这个方向白改了一轮配置——工具并没有拦住我,因为它也在同一个错误假设里工作。 它擅长的是"把两边摆出来比对"这类可核验的机械活;判断方向对不对、以及最后验收结果, 仍然得人来做。工具变快之后,方向错了只会让你更快地跑到错的地方去。
硬件的边界,有一部分是可以商量的
一件硬件的性能上限当然由芯片和屏幕决定。这台机器就是现成的例子:因为是 2018 年的 单核处理器和 6 英寸灰度屏,我主动放弃了常亮看板和动态锁屏——那不是软件能绕开的。
但在性能上限之内,它能做什么,很大程度上是软件决定的。而软件能不能改, 过去是一道实打实的门槛:要翻论坛、读源码、试错,耗的是最容易让人半途而废的那种时间。
这次的体感是,这道门槛比以前矮了。开源软件提供能力,VPS 承担计算和自动化, 云存储解决跨网络连接,本地的 AI 工具处理那些机械且易错的操作。
一台原本定位是"买亚马逊的书、读亚马逊的书"的阅读器,现在读我自己的 Markdown、 读 RSS、读微信读书、还能就地问 AI。硬件一个螺丝没动,变的全是软件。
我不想把这台 Kindle 的经验直接推广成普遍规律——它有几个前提并不是每台设备都具备的: 设备可以解锁、有活跃的开源生态、真正吃算力的部分被放在了 VPS 上。换成一台锁死引导、 没人做适配、或者算力和内存实在不够的设备,结论可能完全相反。
但至少值得重新问一次:那些被你判定为"淘汰了"的设备,究竟是硬件不行, 还是只是"改起来太麻烦"?后面这一条,确实比以前便宜了。
它现在是什么
完成后,这台 Kindle 同时是:EPUB 和 PDF 阅读器、Markdown 文档终端、VPS 内容接收端、RSS 新闻阅读器、微信读书客户端、AI 辅助阅读工具。
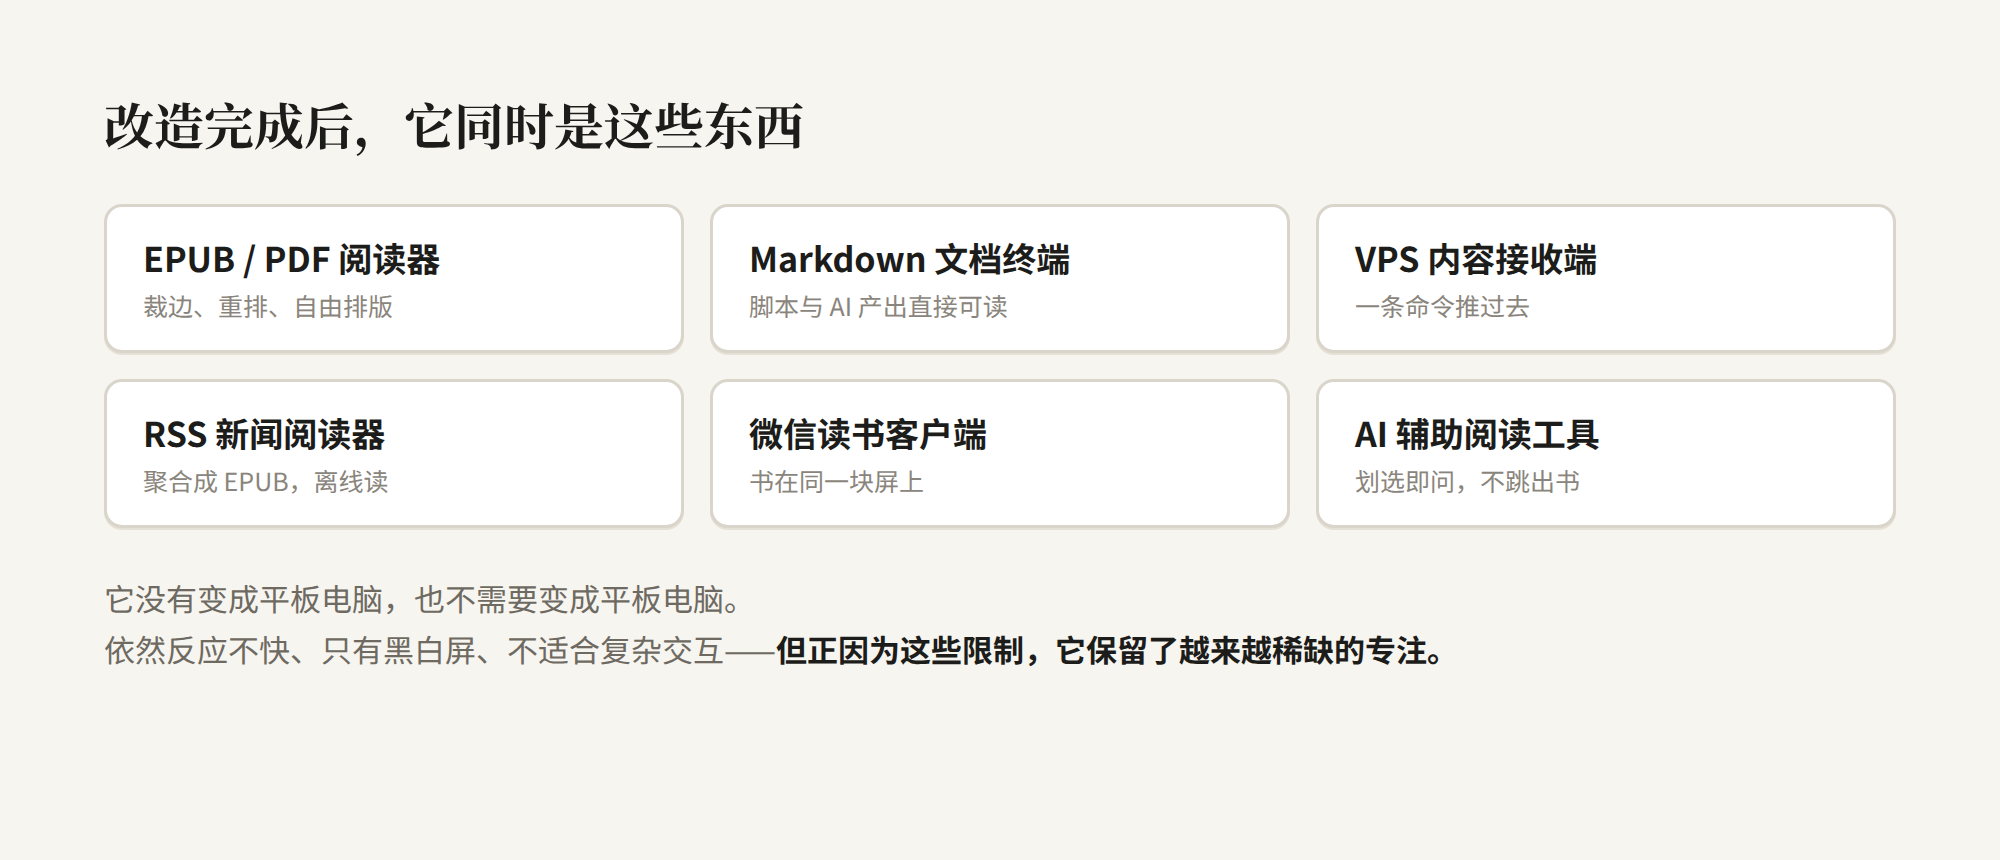
它没有变成平板电脑,也不需要变成。依然反应不快、只有黑白屏、不适合复杂交互——但正因为这些限制,它保留了今天越来越稀缺的专注。
手机负责即时通信,电脑负责生产和处理,VPS 负责自动化,而它只负责最后一件事:把值得读的内容,安静地呈现在眼前。
比"救活一台旧设备"更有用的,是那两个教训。
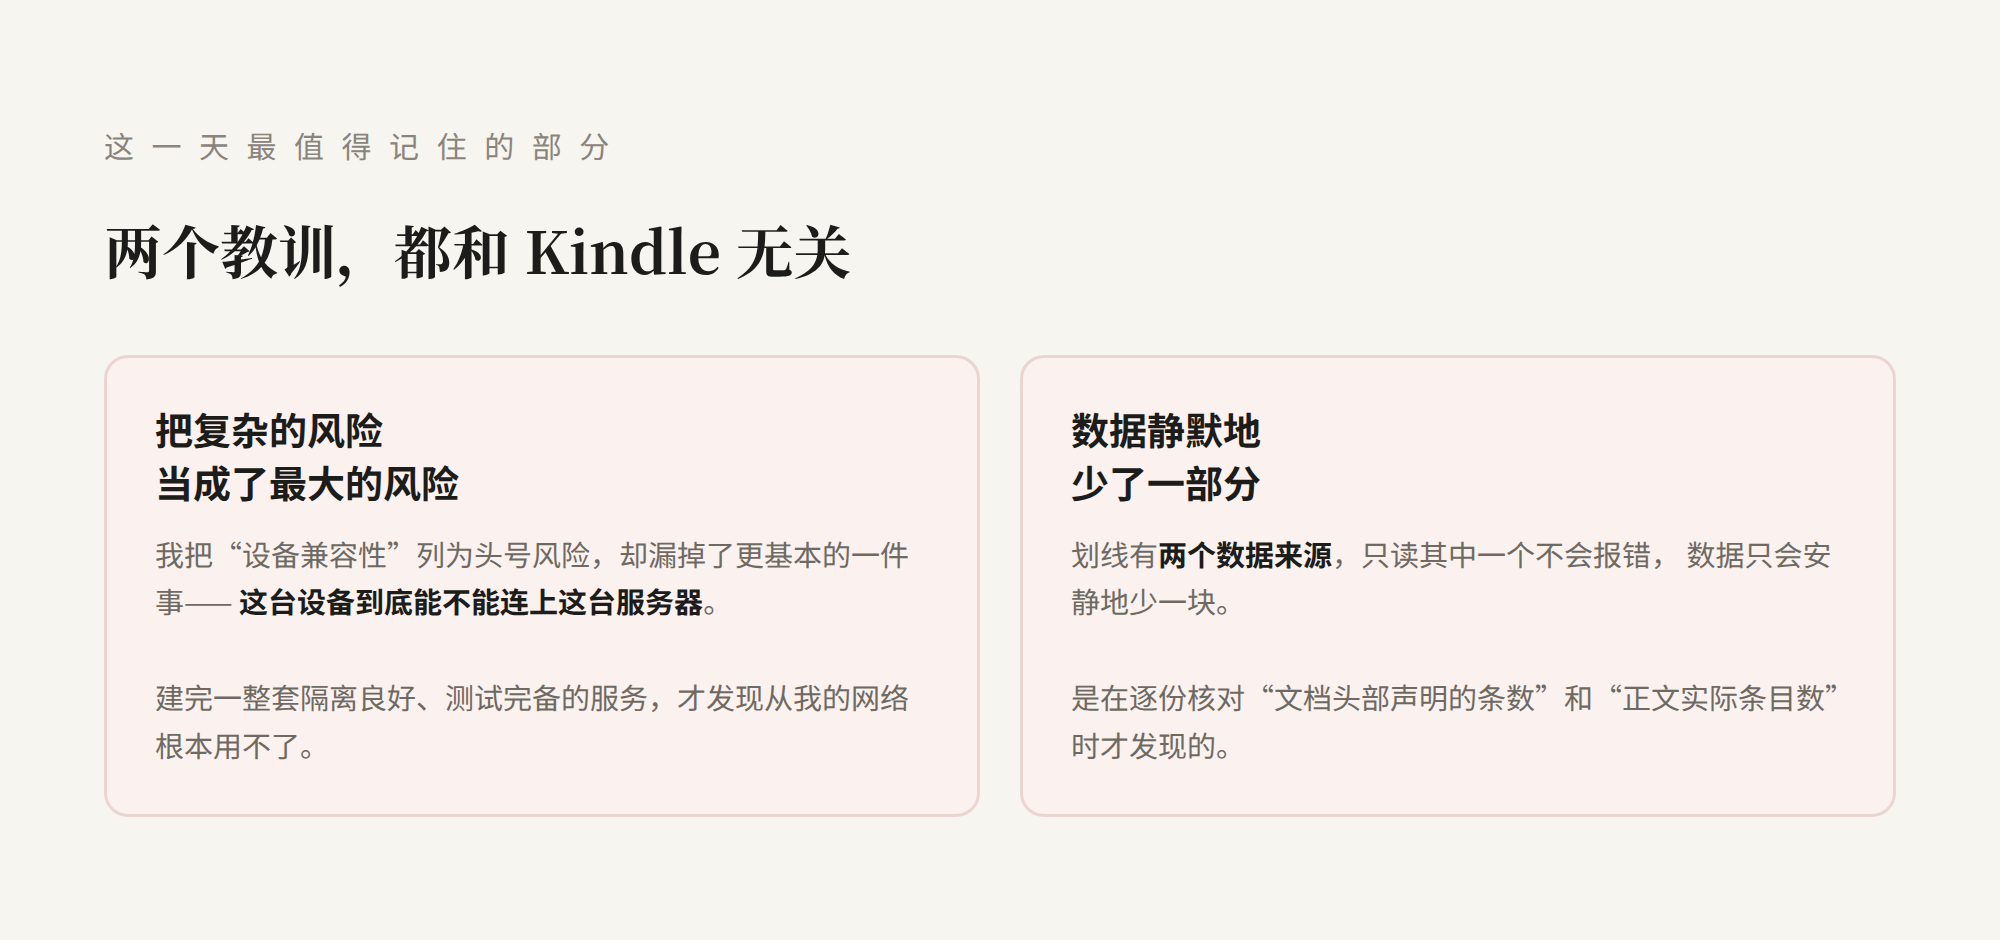
一次是把复杂的风险当成了最大的风险,却漏掉了最基本的那个——建完一整套服务, 才发现网络根本不通。
一次是数据静默地少了一部分,不报错,只有逐条核对才看得见。
这两件事都和 Kindle 无关,但它们大概是这一天里最值得记住的部分。因为工具变快之后, 剩下那个真正难的问题反而更突出了:
你希望这台设备,究竟为你做什么。